こんにちは。雷神久(ライジング)です。
2026年11月12日深夜から13日にかけて、「Outlookでメールの送受信が完全に止まった」「Teamsにログインできない」「OneDriveやSharePointが開かず業務が麻痺している」という悲鳴が世界中、そして日本国内の企業や教育機関から一斉に上がりました。
米マイクロソフト公式が発表したインシデント番号「MO1550821」(Exchange Online個別番号:EX1550543)によると、今回の事象は世界中の数十万人以上のユーザーおよび企業インフラに直撃した歴史的大規模クラウド障害です。
公式アナウンスの中で特にIT関係者やエンジニアの間で大きな波紋を呼んだのが、「多数のサーバーが予期せず停止(利用不能)になった」という衝撃的な報告です。サイバー攻撃や突発的なアクセス急増ではないにもかかわらず、なぜ世界屈指の巨大クラウドインフラでサーバーが一斉にダウンしたのでしょうか?
本記事では、海外の公式一次情報および海外セキュリティメディア(BleepingComputer、The Guardian等)の技術報告に基づき、「多数のサーバーが予期せず停止した技術的真相」「なぜ再起動しても直らなかったのか(復帰即ダウンの罠)」「影響を受けたサービスと現在のステータス」「情シス担当者・ユーザーが取るべき実用的な回避策」を客観的なファクトのみで徹底解説します。
この記事でわかること!
- 障害の全体像と被害規模:Outlook、Teams、OneDrive等の世界的ダウン(MO1550821)
- 「予期せぬサーバー停止」の真相:暗号化接続プロセスの過負荷とヘルスチェック失敗
- カスケード障害(連鎖停止)の連鎖:正常サーバーへ全負荷集中しドミノ倒しダウン
- 復旧が長引いた「再起動の罠」:立ち上がった瞬間にトラフィックを浴びて再沈黙
- 情シス・管理者の対処手順:Service Healthの監視と暫定的な業務回避ルート
1. 世界規模のMicrosoft 365大規模障害(概要とタイムライン)
今回の障害は、協定世界時(UTC)の2026年11月12日 18:26(日本時間 11月13日 午前3:26頃)より発生が確認されました。米国のビジネス時間帯のピークを迎えていたことも重なり、障害発生から数十分の間に米国のDowndetectorではOutlook単体だけで13万件近いユーザー障害報告が殺到しました。
■ 影響を受けた主なMicrosoft 365サービス一覧
- Exchange Online / Outlook:メールの送受信エラー、予定表同期のタイムアウト、接続切断
- Microsoft Teams:メッセージの送信失敗、通話の強制切断、会議への参加不能
- SharePoint Online & OneDrive:ファイルへのアクセス不可、同期保留、ファイルダウンロード失敗
- Microsoft 365 Copilot:AIリクエストに対するタイムアウトエラー、応答の途絶
- Microsoft Defender XDR:管理ポータルへのサインイン不能、アラート監視コンソールの遅延
日本国内でも、13日の早朝業務開始直後から「メールが届かない」「Teamsがつながらない」といった問い合わせが企業のITヘルプデスクへ殺到する事態となりました。
2. 「多数のサーバーが予期せず停止」の技術的メカニズム
最も注目すべきは、マイクロソフトが公式Service Healthおよび管理者向けダッシュボード(MO1550821)で明らかにしたサーバー停止の技術的原因です。
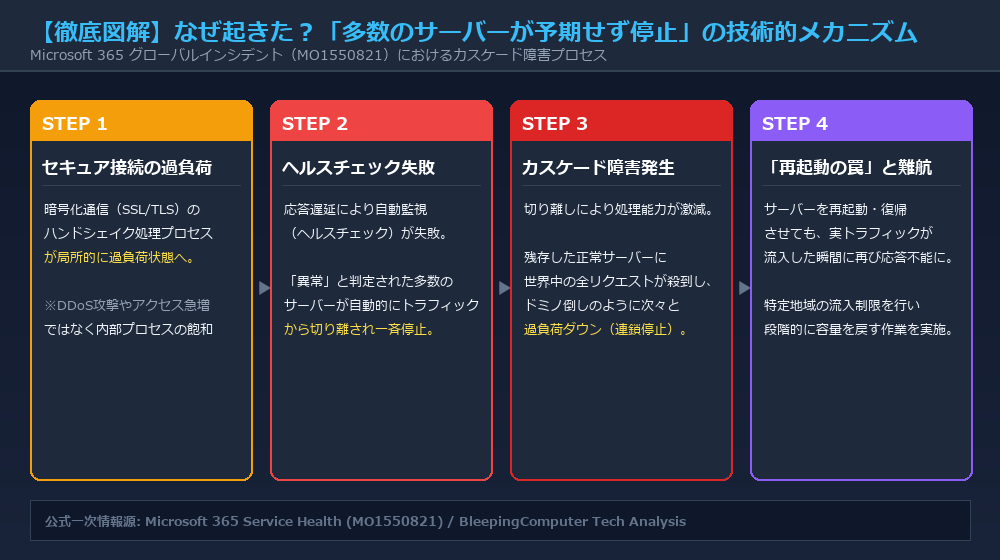
初期のSNS上では「大規模なDDoS攻撃を受けたのではないか」「外部からのハッキングか」という憶測が飛び交いましたが、海外の技術解析レポートおよび公式ステータスはこれを明確に否定しています。発生した現象の全貌は以下の通りです。
① セキュア接続ハンドリングプロセスの局所的過負荷
Microsoftのフロントエンドおよび内部中継サーバー上で、セキュア接続(暗号化通信のSSL/TLSハンドシェイク)を処理する基幹プロセスが過負荷状態(Overwhelmed)に陥りました。これは全体のネットワーク帯域不足ではなく、暗号化セッションの確立と検証を担当する特定プロセスのCPU/メモリリソースが急激に飽和したことに起因します。
② 自動ヘルスチェック(死活監視)の失敗と一斉切り離し
クラウド基盤は、正常に応答できるサーバーだけにトラフィックを割り振るため、ミリ秒単位で「ヘルスチェック(死活監視プローブ)」を行っています。しかし、セキュア接続プロセスが飽和したサーバー群は、ヘルスチェック信号への応答がタイムアウトしました。これにより、ロードバランサーが「異常サーバー」と判断し、多数の健全なはずのサーバーをトラフィックから自動的に一斉切り離し(停止状態へ隔離)してしまったのです。
③ カスケード障害(連鎖的過負荷)の勃発
多数のサーバーが一斉に切り離されたことで、クラウド全体の処理キャパシティが瞬時に激減しました。その結果、行き場を失った膨大な世界中のトラフィックが、わずかに生き残っていた残存サーバー群へ集中。残存サーバーも次々と過負荷に倒れ、ドミノ倒しのようにサーバーが脱落していく「カスケード障害(Cascading Failure)」へと発展しました。
3. なぜ復旧が難航したのか?「再起動の罠(復帰即ダウン)」
障害発生直後、マイクロソフトの運用エンジニアチームは、直近に配布された設定構成(コンフィグ)のロールバックとともに、影響を受けたサーバーインフラの一斉自動再起動を実施しました。
通常のサーバー障害であれば、プロセスの再起動によって溜まっていたセッションやメモリリークが解放され、正常化に向かいます。しかし今回は、クラウド特有の極めて厄介な現象が発生しました。
■ 復旧を阻んだ「復帰即ダウン」の悪循環
再起動を終えてオンラインに復帰したサーバーに対し、ロードバランサーが待機していた実トラフィックを割り振った瞬間、何万件ものセキュア接続要求が一挙に殺到。サーバーは立ち上がった直後に再び過負荷の限界を超え、数秒で再び応答不能(Unresponsive)に逆戻りしてしまいました。
この「再起動→即座に再過負荷で停止」という悪循環を断ち切るため、マイクロソフトは方針を転換。特定地域へのトラフィック流入を意図的に一時制限・スロットリング(流量制御)しながら、サーバーに過剰な負荷をかけずに段階的にキャパシティを復元する代替ワークストリーム(段階的リバランス)を実行するに至りました。
4. 障害の比較まとめ&現在の回復ステータス
今回の事象を技術的観点から一覧表にまとめました。
| 検証項目 | 今回の障害内容(MO1550821) |
|---|---|
| 発生日時 | 2026年11月12日 18:26 UTC(日本時間 11月13日 03:26頃) |
| 根本トリガー | 暗号化通信(セキュア接続)ハンドリングプロセスの過負荷・飽和 |
| サーバー停止理由 | プロセス過負荷による自動ヘルスチェック応答失敗(自動切り離し) |
| 被害拡大の要因 | 切り離し後の残存サーバー群への全負荷集中によるカスケード(連鎖)崩壊 |
| 外部攻撃の関与 | なし(サイバー攻撃やトラフィック不正急増ではないことを公式確認) |
| 現在のステータス | サービス低下(Service Degradation)※順次回復傾向だが完全復旧作業中 |
5. 情シス担当者・一般ユーザーが今すぐ取るべき対策
今回の障害はMicrosoft側のクラウドインフラ内部で発生しているため、ユーザー側のPC再起動やアプリの再インストール、ルーターのリセットを行っても問題は解決しません。むしろ、無駄な再接続を繰り返すことでサーバーへの負荷を高めてしまう可能性があります。
業務影響を最小限に抑えるため、以下の実用的な対処を取ることを強くお勧めします。
■ 今すぐ実践できる4つの実用的対応策
- Microsoft 365 管理センターの「サービス正常性」を常時監視
情シス・管理者は、管理センター(Admin Center)の [正常性] > [サービス正常性] を開き、インシデント MO1550821 および EX1550543 の更新ステータスを随時確認してください。自社テナントの復旧進捗が最も正確に把握できます。 - デスクトップ版アプリからWebブラウザ版(OWA/Teams Web)への一時切り替え
デスクトップ版クライアントでキャッシュエラーや認証ループが発生している場合でも、ブラウザ版(Outlook on the Web)からアクセスすると接続ルートが異なり、送受信に成功するケースがあります。 - 社内連絡手段の一時的フェイルオーバー(予備チャネルの活用)
Teamsが不通の間は、Slack、LINE WORKS、Google Workspace、あるいは社内専用の代替連絡手段へ一時的にシフトし、社内連絡の途絶を防ぎましょう。 - 無駄なパスワード再設定やサインアウトの自粛
障害発生中にパスワードの再設定やMicrosoftアカウントからのサインアウトを行うと、認証サーバーの応答停止により再サインインができなくなり、完全にロックアウトされる危険性があります。状況が安定するまで資格情報の変更は控えてください。
6. まとめ:巨大クラウドが抱える「連鎖停止」のリスク
今回のMicrosoft 365大規模障害は、世界最高峰の冗長性を誇るハイパースケーラーのクラウドであっても、「暗号化プロセスの過負荷」と「自動監視の切り離し判定」が組み合わさることで、一瞬にしてカスケード障害(連鎖停止)へ陥り得るという脆弱性を浮き彫りにしました。
マイクロソフトによる段階的キャパシティ復旧は現在も進行しており、順次正常化に向かっています。業務でM365を基幹として利用している企業は、今後の再発に備え、通信チャネルの多重化やクラウド障害発生時の代替業務マニュアルの策定を進めておくことが極めて重要です。
今後、マイクロソフトから正式なRCA(根本原因分析レポート)や新たな発表があり次第、本記事でも随時最新情報を追記・更新してお伝えします。
コメント